Открытие новых молекул для конкретных применений является основной движущей силой прогресса в самых разных отраслях, будь то фармацевтические компании, ищущие новые лекарства, или компании, занимающиеся электроникой или энергетикой, ищущие новые материалы с особыми свойствами. Но это также во многом процесс проб и ошибок, потому что пока не существует способа точно предсказать, как будет вести себя данное химическое соединение с точки зрения множества различных свойств и реакций, которые могут проявлять материалы.
Недавний прогресс был достигнут в использовании искусственного интеллекта и машинного обучения для дополнения или ускорения трудоемких расчетов, основанных на физических принципах, которые могут, по крайней мере, дать некоторое первоначальное представление о том, какие соединения стоит синтезировать и тестировать. Теперь новый метод, разработанный в Массачусетском технологическом институте, показывает, что, когда имеется мало данных о некоторых технологически значимых свойствах, таких как сродство лиганда к недавно обнаруженной клеточной мишени для потенциального лекарства, этот подход может превзойти другие существующие методы для отсеивания возможных молекул, на которые, возможно, стоит обратить внимание.
Результаты были опубликованы в выпуске журнала Journal of Chemical Information and Modeling от 14 сентября в статье аспиранта Массачусетского технологического института Акшата Шириша Залте и недавнего выпускника Джексона Бернса, доктора философии ’26, научного сотрудника Шарлеса Абреу, профессора Уильяма Грина и трех исследователей из химической компании BASF.
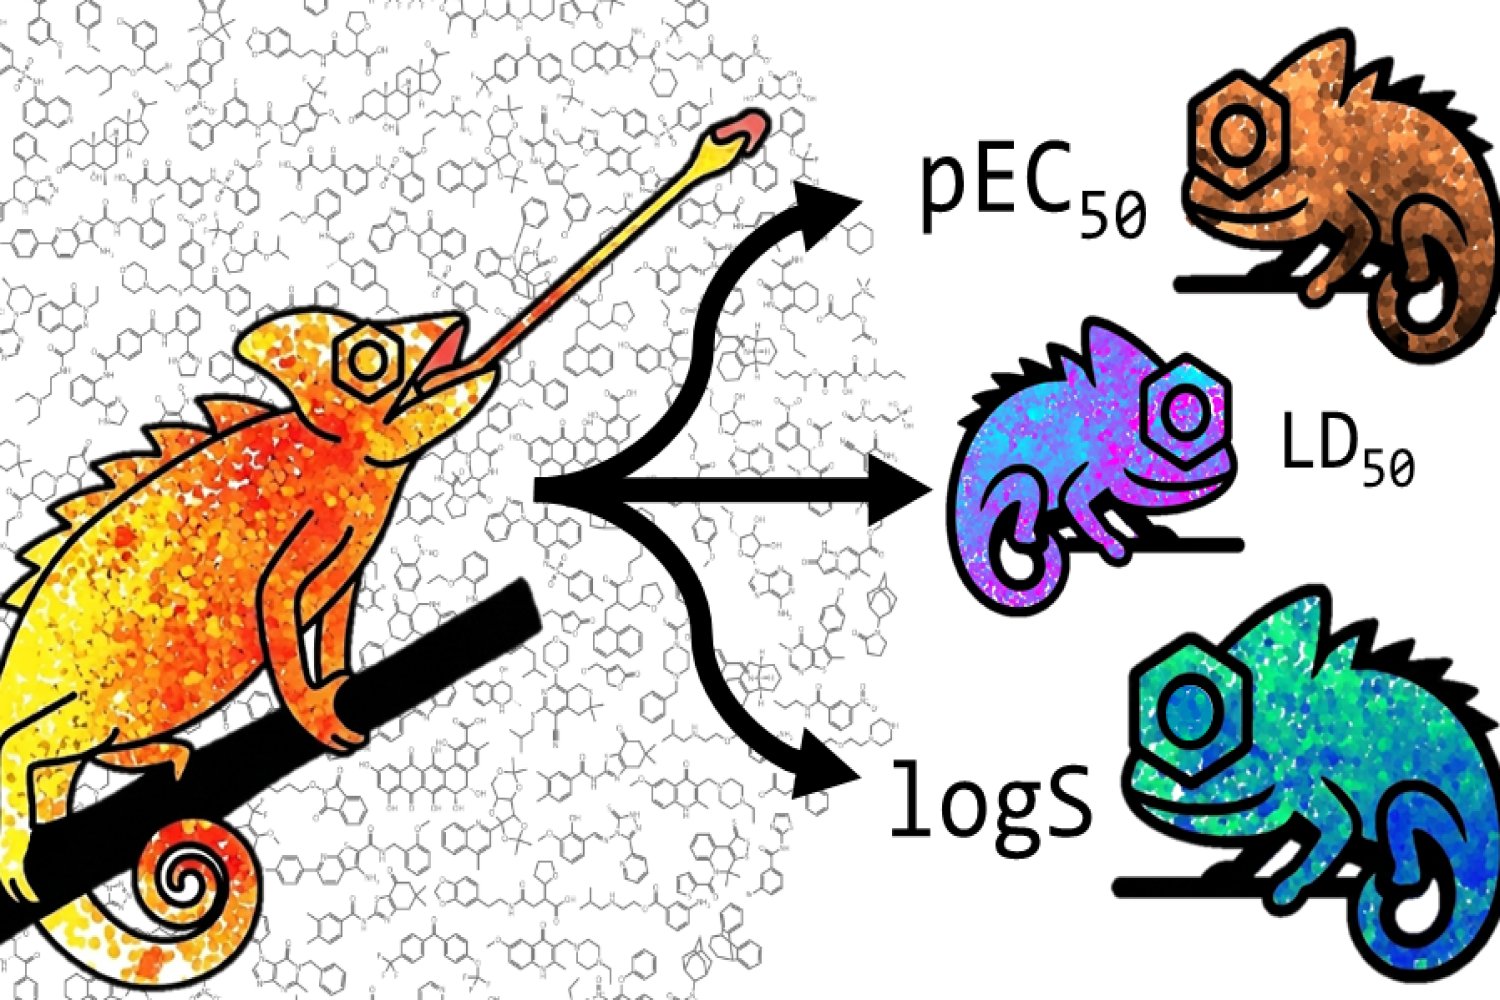
Более ранняя версия статьи доступна в Интернете с прошлого года, а разработанная командой модель с открытым исходным кодом под названием CheMeleon уже нашла регулярное использование в нескольких фармацевтических компаниях. CheMeleon был создан с использованием ChemProp, пакета машинного обучения с открытым исходным кодом, также разработанного и поддерживаемого группой Грина в Массачусетском технологическом институте. Любой может загрузить CheMeleon через ChemProp и настроить его для своих целей.
Ранее в этом году OpenADMET организовал конкурс на попытку предсказать свойства множества новых молекул, которые ранее не были синтезированы, говорит Грин, профессор химической инженерии Хойта Хоттеля. «Это был большой конкурс, в нем приняло участие много людей», — говорит он. Когда были объявлены победители, выяснилось, что девять из 20 лучших заявок использовали CheMeleon в своей работе. «Поэтому мы начали получать всевозможные запросы по этому поводу от фармацевтических компаний, но наша статья только что была отправлена; она еще даже не прошла рецензирование или что-то в этом роде».
Пока статья проходила этот процесс проверки, ее влияние уже распространялось. По крайней мере, одна фармацевтическая компания, по словам Грина, «разослала сообщение всем своим сотрудникам и сказала: «Каждый раз, когда вы моделируете недвижимость, начните с CheMeleon, это наша новая политика компании» при принятии первоначальных решений о том, какие молекулы использовать.
Ключом к CheMeleon была предварительная подготовка модели машинного обучения с подробными данными о миллионе различных молекул, чтобы она могла изучить корреляции между структурой данной молекулы и ее поведением по отношению к каталогу из примерно 1600 дескрипторов, которые разрабатывались химиками на протяжении десятилетий. Затем CheMeleon можно будет точно настроить, чтобы предсказать как хорошо известные свойства, такие как растворимость и вязкость, так и более экзотические свойства, такие как биологическая активность или реакционная способность с определенным белком или ферментом.
Эти миллионы молекул представляют собой ничтожную долю бесчисленных способов, которыми атомы могут соединяться друг с другом, но они предоставляют достаточно примеров, чтобы, как только система ИИ будет обучена на них, она сможет самостоятельно разработать множество основных закономерностей и отношений, а затем применить их к новой, неизвестной молекуле, которая ей будет представлена.
«Большинство современных моделей глубокого обучения требуют больше данных, чем традиционные методы», — говорит Залте. По его словам, в некоторых успешных моделях используются обширные данные из литературы, опубликованной в химических журналах. «Мы вообще не изучаем литературу. Мы просто вычисляем ряд молекулярных дескрипторов, таких как молекулярный вес или количество атомов кислорода и другие». Затем прогнозирование этих дескрипторов составляет основу для задачи предварительного обучения.
CheMeleon — это предварительно обученная базовая модель. Вдохновленный известными базовыми моделями языка, такими как ChatGPT и Claide, которые, по сути, разрабатываются путем подачи огромных объемов информации из Интернета, CheMeleon использует молекулярные дескрипторы миллиона молекул из PubChem, большой, свободно доступной базы данных химической информации, поддерживаемой Национальными институтами здравоохранения США.
С другой стороны, в классических моделях, управляемых экспертами, специалисты в данной области вручную вводят подробные знания по своему предмету. Например, по его словам, при разработке этих классических моделей люди знают из экспериментов, что определенное интересующее свойство, скажем, растворимость, может относиться к конкретным дескрипторам одних и тех же молекул, «таким как молекулярная масса или количество присутствующих атомов кислорода, или насколько разветвленная или громоздкая молекула».
Используя подход этой команды, они могут начать с существующей архитектуры нейронной сети и обучить ее изучению основных принципов. «Мы обучаем ее не для конкретного свойства, а как общую модель, которая понимает определенный уровень химии, так что даже если вы точно настроите ее с помощью всего лишь нескольких точек данных для интересующей вас задачи, вы все равно сможете получить хорошую производительность», — говорит он. Это благодаря тому, что модели «не приходится учиться всему с нуля».
Чтобы убедиться в ее полезности, «мы сравнили нашу модель не только с другими существующими базовыми моделями, но также с классическими моделями, использующими принципы, разработанные экспертами», — говорит Залте. Сравнивая производительность в 58 тестовых случаях, «мы видим, что наша модель выходит на первое место».
Грин добавляет: «Фундаментальная модель CheMeleon радикально сокращает количество молекул, которые необходимо проверить экспериментально, чтобы точно предсказать свойства новых молекул. Это огромное преимущество, поскольку синтез и тестирование большого количества молекул — процесс медленный и дорогостоящий».
Помимо членов MIT, в команду также входили Йохен Зиг, Кристиан Фельдманн и Мириам Матеа, исследователи из BASF SE в Германии. Работа поддерживалась консорциумом «Машинное обучение для фармацевтических открытий и синтеза», а также стипендиальной поддержкой Министерства энергетики США и MathWorks.